Mit diesem Beitrag eröffnen wir eine neue Rubrik: Systeme im Test. Wir setzen in unserem eigenen Betrieb laufend Software ein, die auch unsere Kunden interessiert, und schreiben auf, was wir dabei lernen. Keine Feature-Listen aus dem Prospekt, sondern das, was nach ein paar Wochen Echtbetrieb übrig bleibt. Den Anfang macht Paperless-ngx, das wir seit August 2026 als Dokumentenmanagement für unseren Rechnungseingang und unser Archiv betreiben.
Das Wichtigste vorweg: Paperless-ngx ist ein ausgesprochen gutes Stück Software. Wer es allerdings als „GoBD-konformes DMS“ einführt, weil das irgendwo so steht, bekommt ein Problem. Was es kann und was man selbst bauen muss, ist das Thema dieses Berichts.
Was Paperless-ngx ist – und was nicht
Paperless-ngx ist ein quelloffenes Dokumentenmanagement unter GPLv3, entstanden 2022 als Community-Fork des eingeschlafenen Paperless-ng. Es nimmt Dokumente entgegen, erkennt den Text per OCR, ordnet sie automatisch Korrespondenten, Dokumenttypen und Tags zu und macht sie durchsuchbar. Backend in Python (Django), Oberfläche in Angular, Verarbeitung über eine Warteschlange mit Redis, Datenhaltung in PostgreSQL. Die Oberfläche ist auf Deutsch verfügbar.
Wer ein DMS auswählt, sollte zuerst klären, welche Klasse von System er eigentlich braucht. Paperless-ngx sitzt genau in der Mitte zwischen Sync & Share und Enterprise Content Management:
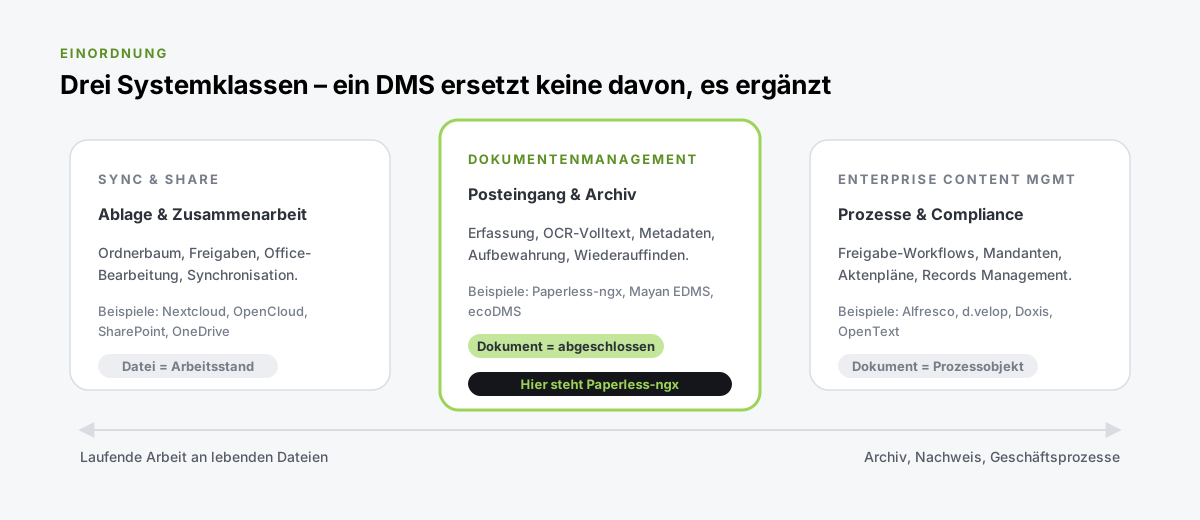
Diese Einordnung war für uns die wichtigste Entscheidung. Wir betreiben bereits OpenCloud für die laufende Zusammenarbeit an Dateien. Paperless-ngx ersetzt das nicht, es ergänzt es: Solange an einem Dokument gearbeitet wird, liegt es in der Cloud. Sobald es abgeschlossen ist oder von außen hereinkommt, gehört es ins DMS. Umgekehrt ist Paperless-ngx kein ECM: Es kennt keine Mandanten, keine Freigabe-Workflows mit Vier-Augen-Prinzip und keinen Aktenplan mit Fristenlauf.
Unser Testaufbau
Wir haben Paperless-ngx nicht in einer Sandbox angeschaut, sondern produktiv gesetzt, mit allem, was dazugehört:
| Merkmal | Unser Aufbau |
|---|---|
| Version | Paperless-ngx 3.0.5, ergänzt um das Parser-Plugin paperless-ngx-erechnung |
| Plattform | Kubernetes (microk8s, vier Knoten), Rollout per GitOps mit ArgoCD |
| Datenbank | PostgreSQL als CloudNativePG-Cluster, TLS erzwungen |
| Speicher | verschlüsseltes NFS/ZFS-Volume, 50 GB Quota |
| Erfassungswege | IMAP-Postfach für Eingangsrechnungen, Upload für gescannte Post |
| Bestand | rund 220 Dokumente nach vier Wochen, zwei Alltagsnutzer, ein Administrator |
| Anspruch | Rechnungseingang inklusive E-Rechnung, Aufbewahrung nach GoBD |
Das ist eine kleine Installation. Aussagen zur Skalierung auf zehntausende Dokumente oder dutzende Nutzer treffen wir bewusst nicht. Aussagen zur Frage, ob Paperless-ngx einen Betrieb mit Nachweispflichten trägt, dagegen schon, denn genau daran haben wir es gemessen.
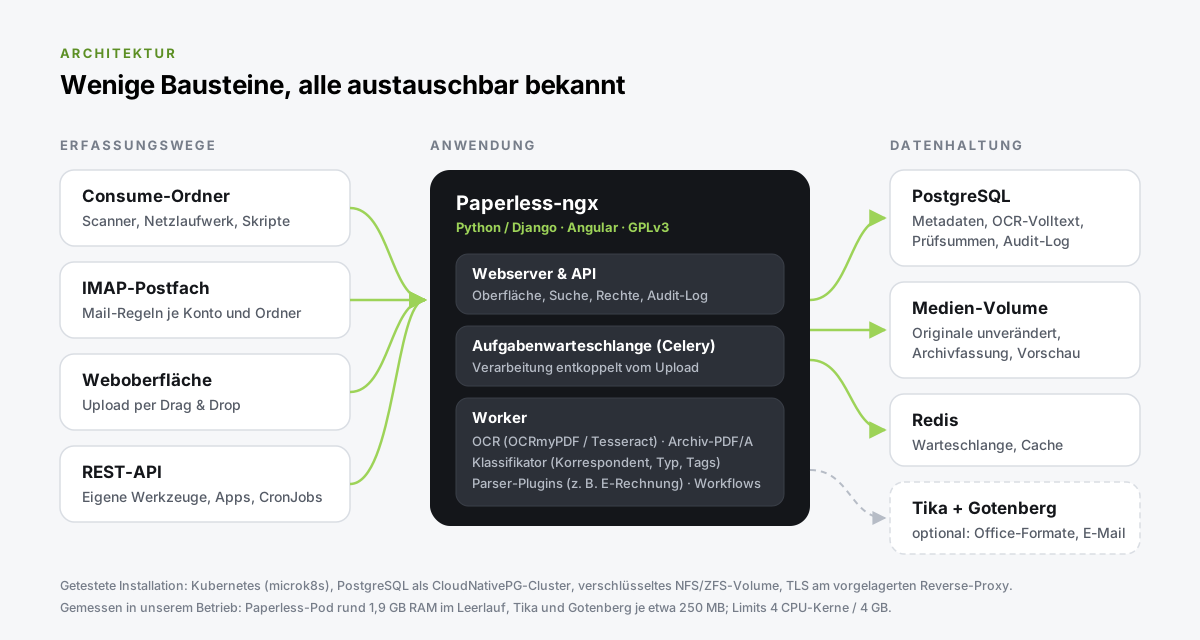
Der Betrieb selbst ist unspektakulär, und das ist ein Kompliment. Ein Anwendungscontainer, dazu Redis und PostgreSQL, optional Tika und Gotenberg für Office-Formate. Alles Standardbausteine, die jedes Team mit Container-Erfahrung kennt. Der Paperless-Pod liegt bei uns im Leerlauf bei rund 1,9 GB Arbeitsspeicher. Updates kommen häufig, die Release-Notes sind brauchbar, die Dokumentation ist gut.
Der Weg eines Dokuments
Das Kernversprechen von Paperless-ngx lautet: Dokument hinein, alles Weitere passiert von allein. Das hält es weitgehend.
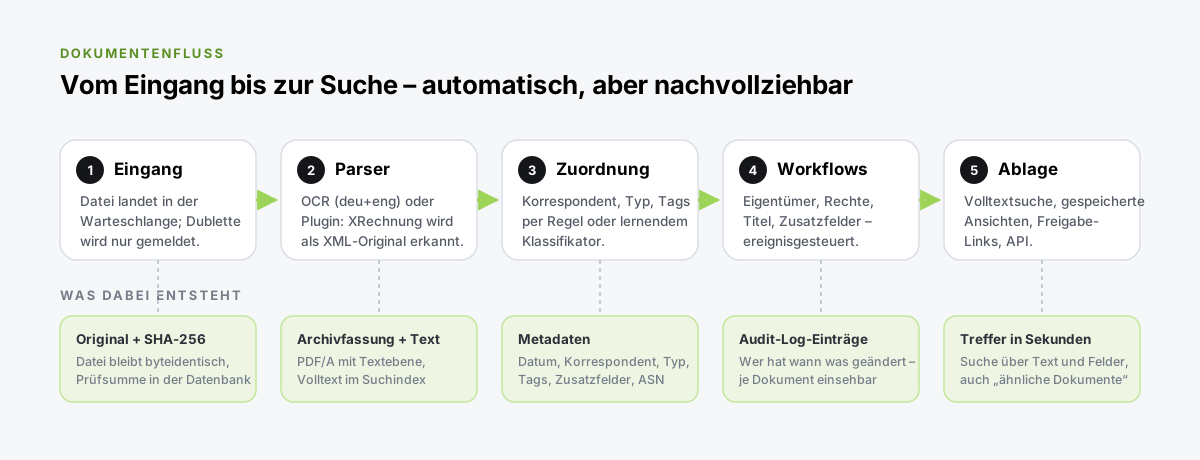
Eine Rechnung, die per Mail eintrifft, wird von der Mail-Regel abgeholt, durch OCR geschickt, als PDF/A mit Textebene archiviert und anhand des erkannten Textes einem Korrespondenten und Dokumenttyp zugeordnet. Die Zuordnung funktioniert über zwei Wege: feste Regeln (etwa „enthält den Text Telekom“) und einen lernenden Klassifikator, der aus den bisherigen Zuordnungen lernt. Der Klassifikator braucht einen Grundstock von Hand zugeordneter Dokumente, bevor er brauchbare Vorschläge macht; in den ersten Wochen korrigiert man viel. Korrespondenten trifft er früher als Dokumenttypen, weil die Textunterschiede zwischen einer Rechnung und einer Auftragsbestätigung desselben Lieferanten klein sind.
Das Original bleibt dabei unangetastet. Paperless-ngx speichert es byteidentisch und legt die SHA-256-Prüfsumme in der Datenbank ab, die Archivfassung ist eine Ableitung daneben. Für alles, was mit Nachweisen zu tun hat, ist das die richtige Konstruktion.
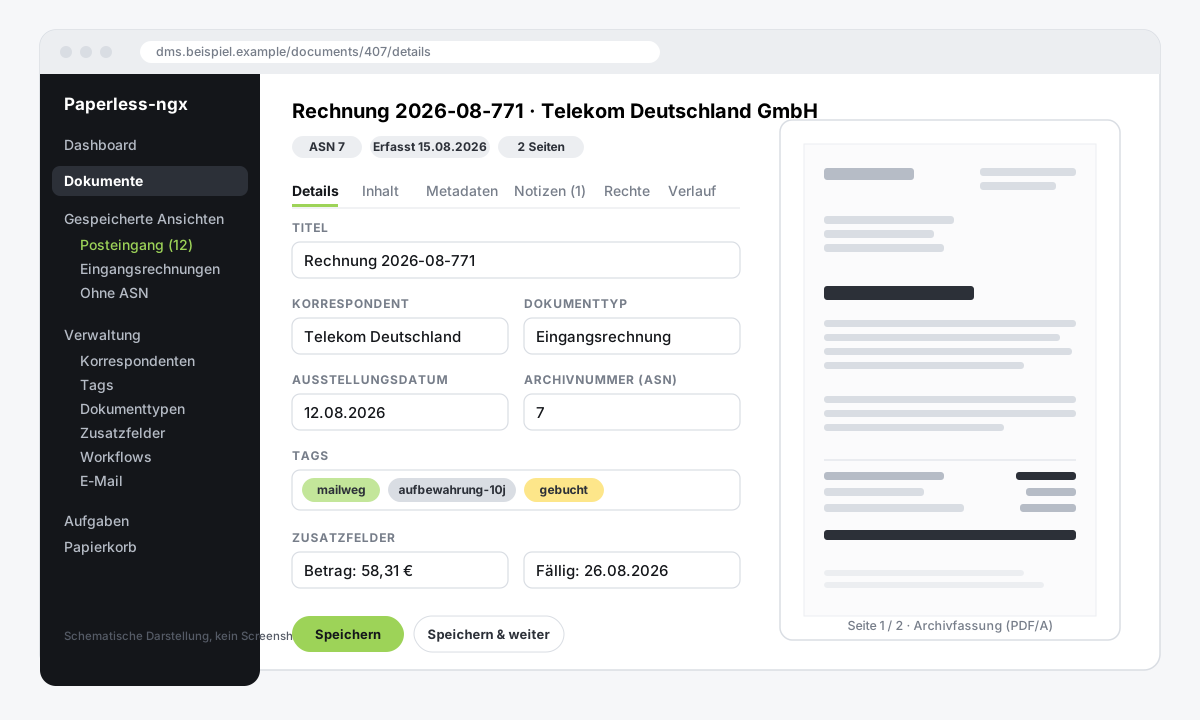
Die Oberfläche ist aufgeräumt und schnell. Metadaten lassen sich direkt am Dokument pflegen, gespeicherte Ansichten ersetzen Ordner, und der Verlauf zeigt je Dokument, wer wann welches Feld geändert hat, sofern das Audit-Log eingeschaltet ist.
Die Stärken
OCR und Suche. Die Texterkennung mit Deutsch und Englisch war in unserem Bestand bislang nie der Grund für ein nicht gefundenes Dokument. Die Volltextsuche antwortet in Sekundenbruchteilen und findet auch Zahlen und Rechnungsnummern in Scans.
Das Metadatenmodell ist bewusst klein. Korrespondent, Dokumenttyp, Tags, Archivnummer, Ausstellungsdatum und frei definierbare Zusatzfelder. Das klingt nach wenig, deckt aber in der Praxis fast alles ab, und es zwingt zu einer Ordnung, die auch in drei Jahren noch jemand versteht.
Mail-Regeln und Consume-Ordner. Unser Rechnungseingang läuft seit dem ersten Tag ohne Zutun: Postfach, Regel, fertig. Die Regeln können nach Absender, Betreff und Anhangstyp filtern und die verarbeitete Mail verschieben oder markieren.
Die REST-API ist vollständig. Alles, was die Oberfläche kann, geht auch über die Schnittstelle, sauber dokumentiert und mit Token-Authentifizierung. Für uns war das entscheidend, weil wir sämtliche Kontrollen darüber gebaut haben.
Audit-Log. Einschaltbar, seit unserem ersten Tag aktiv. Es protokolliert je Dokument, Korrespondent, Tag, Notiz und Zusatzfeld, wer wann was geändert hat, und das ist über API und Oberfläche einsehbar.
Parser-Plugins. Seit Version 3.0 lassen sich eigene Parser als Python-Paket nachrüsten, ohne den Quellcode anzufassen. Wir haben darüber XRechnung und ZUGFeRD angebunden: Das XML bleibt als Original erhalten, als Ansicht wird per offizieller KoSIT-Visualisierung ein PDF gerendert. Das hätte es vor 3.0 nur als Fork gegeben.
Kosten und Betrieb. Keine Lizenzkosten, ein kleiner Fußabdruck, eine aktive Community mit kurzen Release-Zyklen. Für einen kleinen Betrieb ist das mit Abstand die günstigste Art, zu einem echten Dokumentenarchiv zu kommen.
Die Schwächen
Wir haben Paperless-ngx an einem Anspruch gemessen, den es selbst nirgends erhebt: revisionssichere Aufbewahrung nach GoBD. Die meisten Schwächen, die wir gefunden haben, hängen damit zusammen. Aber nicht alle.
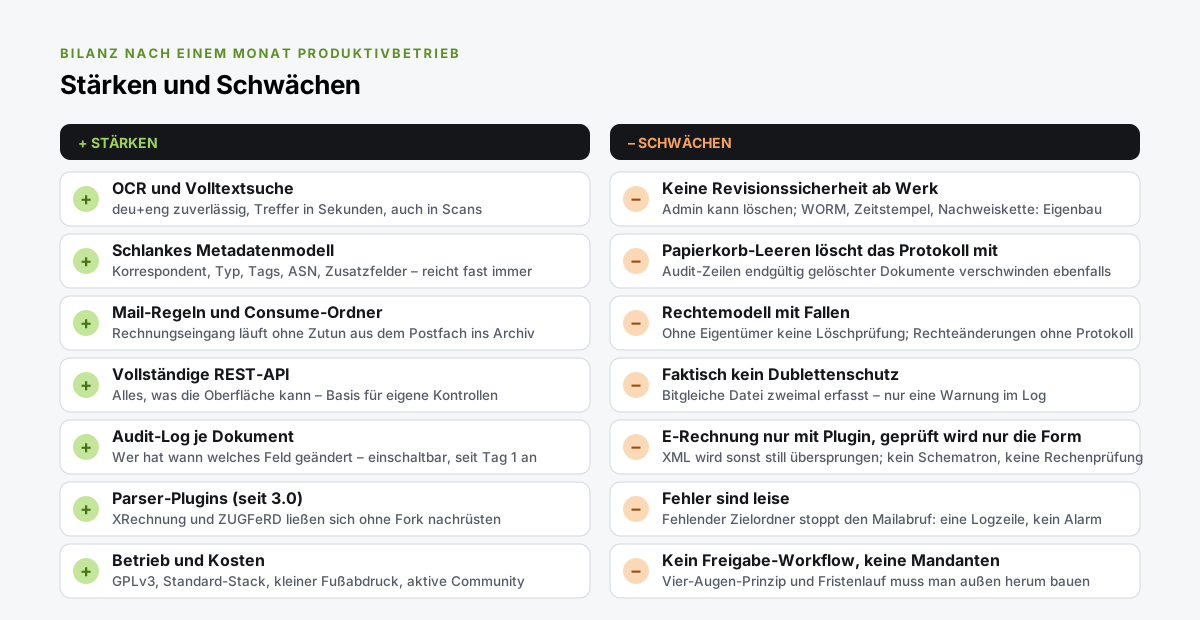
Keine Revisionssicherheit ab Werk. Ein Administrator kann jedes Dokument endgültig löschen. Es gibt keinen WORM-Speicher, keinen Zeitstempel, keine Kette, die nachträgliche Änderungen sichtbar macht. Das ist keine Kritik an der Software, denn sie verspricht das nicht. Es ist eine Kritik an der verbreiteten Annahme, ein DMS mit Audit-Log sei damit schon GoBD-konform.
Papierkorb-Leeren löscht das Protokoll mit. Das war unser unangenehmster Fund. Wird ein Dokument aus dem Papierkorb endgültig entfernt, löscht Paperless-ngx auch die zugehörigen Zeilen im Audit-Log, und schreibt keinen Löscheintrag. In der Datenbank ist danach nicht mehr nachweisbar, dass das Dokument je existiert hat. Wer den Nachweis braucht, muss das Protokoll regelmäßig nach außen exportieren, bevor die automatische Papierkorb-Leerung läuft.
Das Rechtemodell hat Fallen. Bei einem Dokument ohne Eigentümer entfällt im Papierkorb die Eigentümerprüfung: Jedes Konto, das an den Papierkorb herankommt, darf es endgültig löschen. Genau so lagen unsere ersten Testdokumente da. Und Änderungen an Benutzern, Gruppen und Rechten werden vom Audit-Log gar nicht erfasst: Wer sich selbst das Löschrecht gibt, hinterlässt keine Spur. Beides lässt sich einhegen, mit einem Workflow, der jedem neuen Dokument einen Eigentümer gibt, und mit einer externen Kontrolle des Rechtemodells. Aber man muss es wissen.
Faktisch kein Dublettenschutz. Kommt dieselbe Datei zweimal an, etwa weil eine Rechnung zweimal weitergeleitet wird, erfasst Paperless-ngx sie in der Standardeinstellung zweimal und schreibt lediglich eine Warnung ins Log. Die Alternative, Dubletten automatisch zu verwerfen, ist für einen Rechnungseingang mit Zählabgleich ebenfalls unbrauchbar.
E-Rechnung: nur mit Plugin, und geprüft wird nur die Form. Ohne Plugin überspringt die Mail-Regel XML-Anhänge stillschweigend. Eine XRechnung kommt also gar nicht erst an, und niemand merkt es. Mit Plugin wird die Rechnung angenommen, aber nur auf Wohlgeformtheit und Profil geprüft. Eine Rechnung ohne Rechnungsnummer oder mit falscher Summe wird ohne Beanstandung archiviert. Eine fachliche Validierung nach EN 16931 muss davor oder danach jemand anderes machen.
Fehler sind leise. Als bei uns ein Zielordner im Postfach fehlte, brach Paperless-ngx die Mail-Regel vor dem Abholen ab. Über einen Tag lang kam keine Rechnung mehr an. Im Log stand dazu eine einzige Zeile, in der Oberfläche nichts. Das gleiche Muster zeigt sich an mehreren Stellen: Ein API-Filter mit falschem Datumsformat liefert kommentarlos alle Dokumente statt eines Fehlers. Wer Paperless-ngx in einen Prozess einbaut, auf den er sich verlassen muss, braucht eine eigene Überwachung von außen.
Kein Freigabe-Workflow, keine Mandanten. Die eingebauten Workflows sind ereignisgesteuerte Zuweisungen: Wenn ein Dokument hinzukommt, setze Eigentümer, Titel, Tags. Ein mehrstufiger Freigabeprozess, eine Wiedervorlage oder ein automatischer Fristenlauf für die Aufbewahrung sind damit nicht abbildbar. Und eine Installation ist ein Mandant. Wer mehrere braucht, betreibt mehrere Instanzen.
Was wir darum herum gebaut haben
Weil wir den GoBD-Anspruch nicht aufgeben wollten, haben wir die Nachweiskette außerhalb der Anwendung gebaut. Das ist der Teil, den man einplanen muss, wenn man Paperless-ngx im Unternehmen einsetzt.
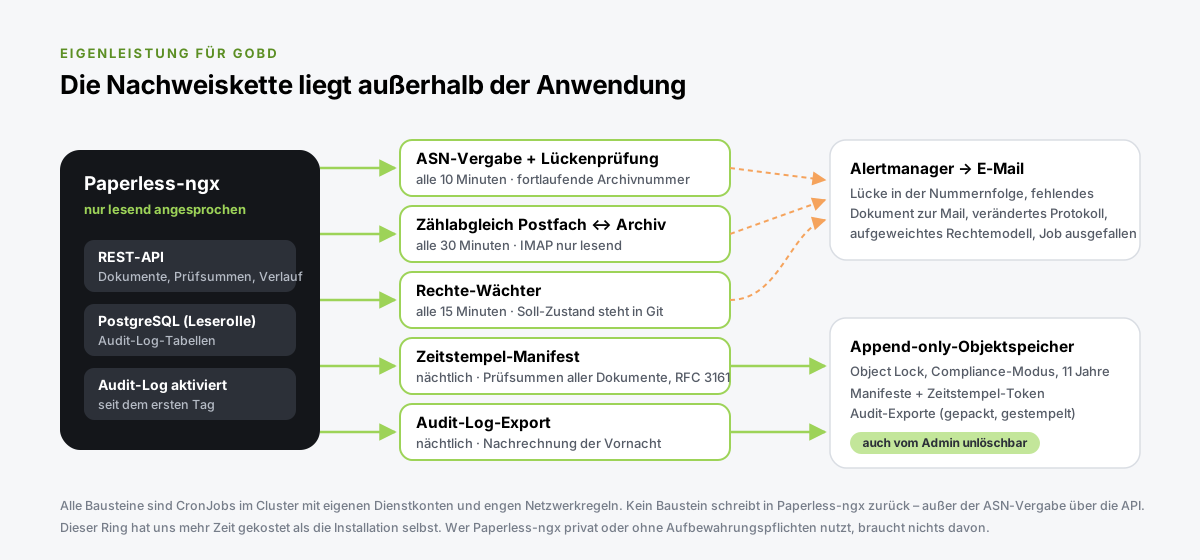
Fünf zeitgesteuerte Jobs im Cluster lesen Paperless-ngx über die API oder eine reine Leserolle auf der Datenbank:
- Archivnummern-Vergabe und Lückenprüfung. Jede Eingangsrechnung erhält eine fortlaufende Nummer, die Folge wird alle zehn Minuten auf Lücken geprüft. Paperless-ngx vergibt die Nummer nicht selbst, außer über Barcodes auf Papier.
- Zählabgleich gegen das Postfach. Alle dreißig Minuten wird verglichen, ob zu jeder verarbeiteten Mail ein Dokument existiert. Das ist die einzige Kontrolle, die das Fehlen eines Belegs bemerkt.
- Rechte-Wächter. Der Soll-Zustand des Rechtemodells steht in Git. Weicht die Anwendung davon ab, gibt es einen Alarm. Das schließt die Lücke, dass Rechteänderungen nicht protokolliert werden.
- Zeitstempel-Manifest. Jede Nacht werden die Prüfsummen aller Dokumente in ein Manifest geschrieben, mit einem RFC-3161-Zeitstempel versehen und in einem Objektspeicher abgelegt, dessen Object Lock im Compliance-Modus auch dem Administrator das Löschen für elf Jahre verwehrt.
- Audit-Log-Export. Ebenfalls nächtlich, in denselben Speicher, und mit einer Nachrechnung: Stimmen die gestern exportierten Zeilen heute noch mit der Datenbank überein?
Alle fünf melden an unseren Alertmanager. Der Punkt dabei ist nicht, dass das alles kompliziert wäre. Der Punkt ist, dass es außerhalb der Anwendung liegt und deshalb auch dann gilt, wenn jemand mit Administratorrechten in der Anwendung etwas verändert. Dieser Ring hat uns mehr Zeit gekostet als die Installation selbst. Wer Paperless-ngx privat oder ohne Aufbewahrungspflichten nutzt, braucht nichts davon.
Für wen es passt
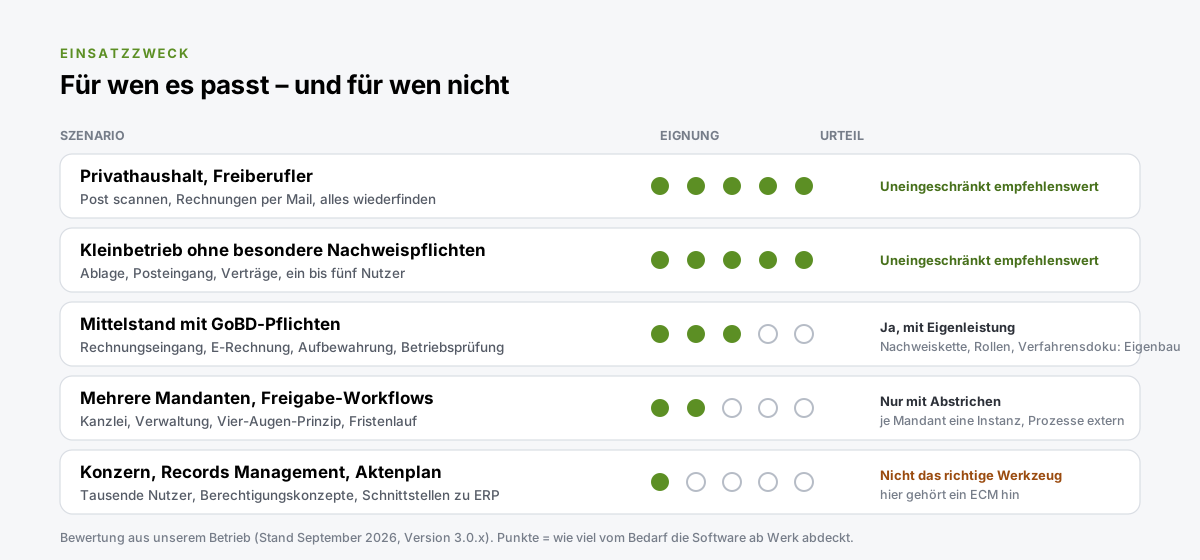
Uneingeschränkt empfehlenswert ist Paperless-ngx für Privathaushalte, Freiberufler und kleine Betriebe, die ihre Post, Verträge und Rechnungen wiederfinden wollen. Hier spielt es alle Stärken aus und keine der Schwächen wiegt schwer. Wir kennen in dieser Klasse nichts Besseres, kommerzielle Produkte eingeschlossen.
Ja, mit Eigenleistung lautet unser Urteil für den Mittelstand mit GoBD-Pflichten. Die Software ist eine solide Basis, aber Revisionssicherheit, Rollentrennung, Überwachung und Verfahrensdokumentation sind Eigenleistung. Wer die nicht erbringen kann oder will, ist mit einem kommerziellen DMS mit Testat besser bedient, auch wenn es ein Vielfaches kostet.
Nur mit Abstrichen taugt es für Kanzleien und Verwaltungen mit mehreren Mandanten oder echten Freigabeprozessen. Das geht mit einer Instanz je Mandant und Workflows außen herum, aber man arbeitet dann gegen das Werkzeug.
Nicht das richtige Werkzeug ist es für Konzerne mit Records Management, Aktenplan und tausenden Nutzern. Dort gehört ein ECM hin, und Paperless-ngx behauptet auch nichts anderes.
Unser Fazit
Wir bleiben bei Paperless-ngx und würden es wieder so machen. Es ist schnell, gut gebaut, gut dokumentiert und über die API so offen, dass sich alles, was fehlt, sauber ergänzen lässt. Der Fehler, den wir bei anderen sehen, liegt nicht in der Software, sondern in der Erwartung: Ein Dokumentenarchiv mit OCR und Audit-Log ist noch kein revisionssicheres Archiv. Wer das weiß und die Lücke bewusst schließt, bekommt für null Euro Lizenzkosten ein DMS, das seinen Zweck erfüllt. Wer es nicht weiß, bekommt ein sehr komfortables Archiv, aus dem Dokumente spurlos verschwinden können.
Die Grafiken in diesem Beitrag sind schematische Darstellungen und keine Bildschirmfotos unserer Installation. Alle Befunde beziehen sich auf Paperless-ngx 3.0.5, Stand September 2026.